01 / 能力 × 互動速度
重要工作與快速來回
新版 AA 52 分、首個答案約 8 秒;適合反覆討論、規劃與高品質協作。更難時可測 High(55 分),但標準測試等待約 123 秒,升級有明顯延遲代價。
Astra Medium
| 評測與規格 |
|---|
Epoch 全系列重新查核於 2026-11-04;未逐項確認思考配置的結果保留在模型層級,不代填 Max。Parallel 保留各頁所列測試日期。
只收錄 Epoch AI 自行執行的結果,數值為四捨五入摘要。SpireClimb 方法採各模型最高推理檔位;MirrorCode 方法採 High(支援時)。其他項目配置不一定相同。ECI 為綜合指數。
| 評測 | Astra | Sol 6.1 | Terra 6.1 | Sol 6 | Luna |
|---|---|---|---|---|---|
| ECI | 169 | 168 | 168 | 164 | 157 |
| SpireClimb · Max | 26% | 25% | — | 8% | 0% |
| Chess Puzzles | 76% | 68% | — | 56% | 36% |
| Earthborne Rangers | 76% | 54% | 78% | 53% | — |
| Mystery Game Puzzles | 84% | 80% | 74% | 56% | 7% |
| FrontierMath Erdős | 3% | 4% | — | 1% | — |
| FrontierMath Tiers 1–3 v2 | 94% | 94% | 91% | 90% | 79% |
| FrontierMath Tier 4 v2 | 98% | 100% | 93% | 90% | 56% |
| OTIS Mock AIME 2024–2025 | 100% | 100% | 100% | 100% | 99% |
| Furniture Assembly | 80% | 80% | 79% | 58% | 44% |
| GPQA Diamond | 96% | 95% | 94% | 94% | 90% |
| MirrorCode · High | 47% | — | — | — | 27% |
| SimpleQA Verified | 76% | 74% | 57% | 61% | 41% |
Terra 評測與榜單日期 2026-10-31;其餘模型保留 09/22–09/30 的測試。綜合分數為 DSQA、HLE、WISER 等權平均;成本包含搜尋及擷取。Terra 成本未報,不能當作零。
| 評測 | Astra | Sol 6.1 | Terra 6.1 | Sol 6 | Luna |
|---|---|---|---|---|---|
| 搜尋綜合分數 | 70.8 | 70.4 | 69.7 | 66.6 | 61.9 |
| 無搜尋綜合分數 | 43 | 39.8 | 28.6 | 37.9 | 28 |
| 搜尋提升(分) | 27.9 | 30.6 | 41.2 | 28.7 | 33.9 |
| DSQA · 有搜尋 | 89.5% | 87.1% | 89.1% | 81.9% | 78.7% |
| DSQA · 無搜尋 | 57.9% | 53.4% | 39.7% | 54.8% | 45% |
| HLE · 有搜尋 | 49% | 48% | 45% | 48% | 42% |
| HLE · 無搜尋 | 52% | 45% | 32% | 40% | 31% |
| WISER · 有搜尋 | 74% | 76% | 75% | 70% | 65% |
| WISER · 無搜尋 | 19% | 21% | 14% | 19% | 8% |
| 每千任務成本(USD) | $401 | $130 | — | $183 | $33.1 |
依公開測試的選型推論;標準 API 速度不等於 Fast 或訂閱配額。
新版 AA 52 分、首個答案約 8 秒;適合反覆討論、規劃與高品質協作。更難時可測 High(55 分),但標準測試等待約 123 秒,升級有明顯延遲代價。
新版 AA 50 分、Codex Max 指數 54。High 每 AA 任務約 $0.59、首個答案約 87 秒;非同步任務較合適。互動頻繁時先試 Medium(約 9 秒)。
官方強項是視覺、電腦操作與寫作。Medium 約 4.24 秒開始回答、500-token 約 9.81 秒;綜合 AA 38 分。若要更多能力,可試 High(42 分,約 21 秒)。
Codex v2 指數 48,與 Max 同分;每任務 $0.69/16.4 分鐘,低於 Max 的 $1.24/26.1 分鐘。這是同一 Codex 測試的取捨,並非所有任務保證等效。
輸入/輸出單價 $0.10/$0.50;AA 首個答案約 0.85 秒。適合能用明確規則驗證的簡單任務;新版綜合指數 9,複雜工作應轉交較強模型。
新版 AA Max 44 分,輸出約 154 tokens/s;其他檔位的新總分多數未評。既有流程若穩定可保留;新工作應一起比較 Sol 6.1 與 Terra。
Terra Max 的 AA FrontierCode 2.0 達 42.3%,接近 Astra Max 的 42.4%,但 Codex 綜合指數為 48,低於 Astra 55、Sol 6.1 54。單一強項不能取代完整任務驗證。Epoch 的 Terra/Sol 6.1 ECI 同為 168,也不等於每種工作相同。
更高的輸出 tokens/s 不等於更快完成回應:Terra Max 仍要約 289 秒才開始回答;Max 適合可等待的工作。實際選型應一起看成功率、延遲與每件成功任務成本。不同測試設定、版本和機構的分數分開閱讀。
本月稍早,我們推出了 GPT‑6 Astra——全球智慧程度最高、對齊表現最好的模型。要求最嚴苛、最重要的專案仍需要 Astra 的完整深度,但工作本來就有不同的規模、節奏與預算。
因此,我們將 GPT‑6 家族擴展至 GPT‑6 Sol 與 GPT‑6 Luna。GPT‑6 Astra 開啟了新一代智慧模型;Sol 與 Luna 則推進成本效益的前緣,讓更多人能享受到這些智慧進展。我們採用與 GPT‑6 Astra 相近的方法訓練 Sol 和 Luna,把 Astra 在專業工作、事實準確性、程式開發、電腦操作及對齊方面達到領先水準的成果,帶到速度更快、價格更親民的模型上。
GPT‑6 系列在成本與智慧的關係上處於領先位置:各個級距都具備出色能力,並透過可大規模提供服務的基礎設施提高效率。快取與推論的改善降低了模型的服務成本;我們也將節省的成本直接回饋給使用者與客戶:與 GPT‑5.6 的促銷價格相比,Sol 和 Luna 的 API 價格降低了 50%。這些改善使先進 AI 更適合大規模應用於日常工作與產品。
| 模型 | 輸入 | 輸出 | 價格降幅 |
|---|---|---|---|
| GPT‑5.6 Sol → GPT‑6 Sol | $4 → $2 | $20 → $10 | 降低 50% |
| GPT‑5.6 Luna → GPT‑6 Luna | $0.20 → $0.10 | $1.20 → $0.50 | 降低 50% |
價格以每 100 萬個 token 計算。
GPT‑6 Astra 仍然是我們在各方面表現最好的模型。如果你希望得到最佳結果,並追求毫不妥協的使用體驗,請選擇 Astra。
GPT‑6 Sol 與 Luna 為你熟悉並正在使用的模型帶來智慧升級與更好的成本效益,尤其是在完成複雜工作最需要的能力上。
GPT‑6 Sol 能處理困難的工作任務,同時以更高的使用額度和更低的成本,讓你有更多反覆調整的空間;與價格相近的競品相比,也能提供更高的智慧程度與更好的成果。
在測試跨應用程式商業工作流程的 AutomationBench 中,GPT‑6 Sol 使用 xhigh 思考檔位的表現優於使用 max 檔位的 Claude Opus 5,而每項任務的成本僅為後者的 9%。使用 high 檔位的 GPT‑6 Luna 則比上一代提高 5.4 個百分點,每項任務的成本降低 58%。
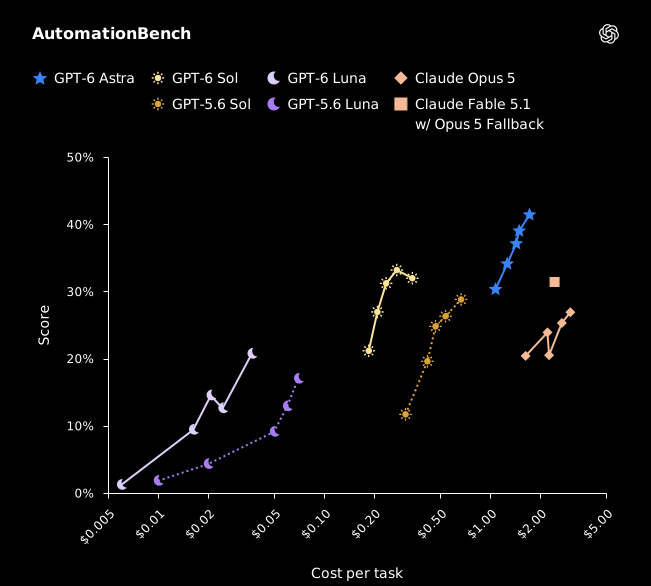
在 AutomationBench 1.0.6 中,AI 代理使用 47 種工具,完成涵蓋銷售、行銷、營運、客服、財務及人資的端到端工作流程。Claude Fable 5.1 的資料點低估了實際成本,因為其中未計入約 40% 任務中使用 Opus 5 後備模型的成本。
GPT‑6 Sol 的表現也優於 Claude Fable 5.1,成本卻低得多;甚至超過使用 low 思考檔位的 GPT‑6 Astra。
| 模型與思考檔位 | 分數 | 每項任務成本 |
|---|---|---|
| GPT‑6 Sol(xhigh) | 33.2% | $0.27 |
| GPT‑6 Astra(low) | 30.3% | Sol 的 3.9 倍 |
| Claude Opus 5(max) | 26.9% | Sol 的 11.1 倍 |
| Claude Fable 5.1+Opus 5 後備模型(max) | 31.4% | 超過 Sol 的 8.9 倍(未公布後備模型成本) |
在評測代理完成複雜專業工作流程能力的 Agents’ Last Exam 中,GPT‑6 Sol 使用 max 檔位取得 56.4% 的成績,超過 Claude Opus 5 在這項評測中的最高分,而每項任務的成本降低 60%。
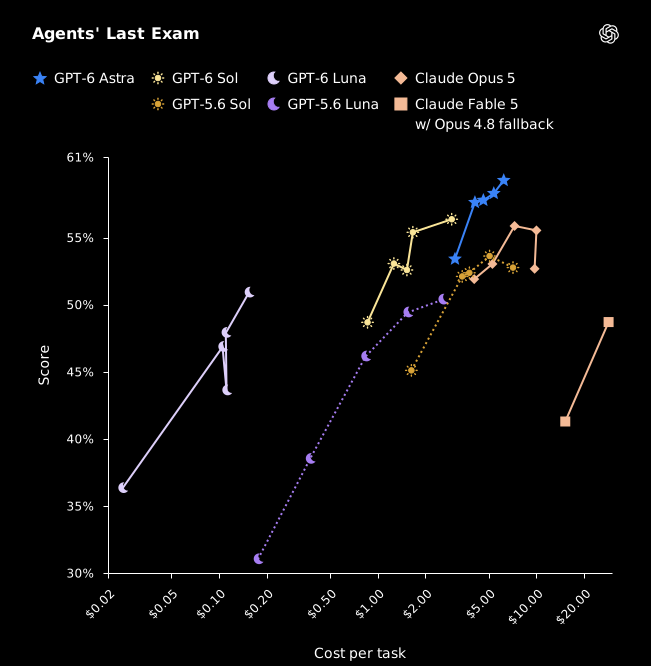
在 Agents’ Last Exam V1 中,AI 代理接受長時間跨度、具經濟價值的任務評測。任務涵蓋 55 個子產業,以及多數主要的電腦上專業工作領域。
答案是否有用,取決於事實是否正確;我們持續提升模型的事實可靠性。在我們的內部事實準確性評測中,測試題目來自經去識別化處理、且使用者曾指出模型出錯的真實對話。GPT‑6 Sol 的錯誤約為上一代的一半,以低得多的成本接近 Astra 的可靠程度。GPT‑6 Luna 也有顯著改善:在較高思考檔位下,它以約百分之一的成本,達到與 GPT‑5.6 Sol 相當的表現。
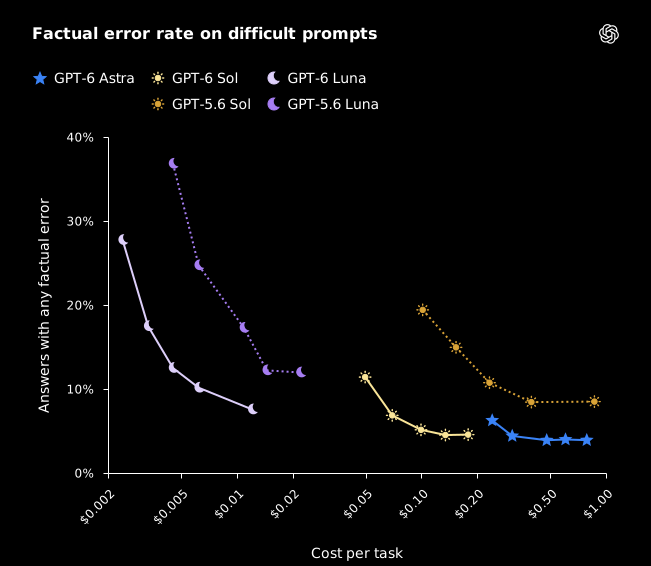
此處使用經去識別化處理的 ChatGPT 對話評測事實準確性;使用者曾指出舊模型在這些對話中犯下事實錯誤。這些容易引發錯誤的對話不代表一般使用情況,日常使用中的事實錯誤較少。分數未控制回答長度;不過,我們對回答詳略的測試顯示,錯誤率與回答長度幾乎沒有關聯。
今年,程式開發代理開始承接比以往更複雜、範圍更廣、時間更長的任務。在 OpenAI 內部,我們的使用量呈指數成長。若以 API 價格估算,每日 token 用量的價值,在研究員中位數已超過 600 美元,在第 90 百分位的研究員則超過 7,000 美元(參見《研究加速:從 OpenAI 內部觀察》)。隨著程式開發代理承擔更長、更困難的任務,持續使用的成本也變得更加重要。GPT‑6 Sol 與 Luna 結合強大的程式開發能力和更低的 API 價格,讓開發者有更多迭代空間,也讓團隊更有信心把更具挑戰性的工作交給 Codex。
在評測程式開發代理能否產出可合併至實際程式庫的修改的 FrontierCode 中,GPT‑6 Sol 相較 GPT‑5.6 Sol 大幅進步,並能以低得多的成本達到 Claude Fable 5.1 xhigh 的水準。
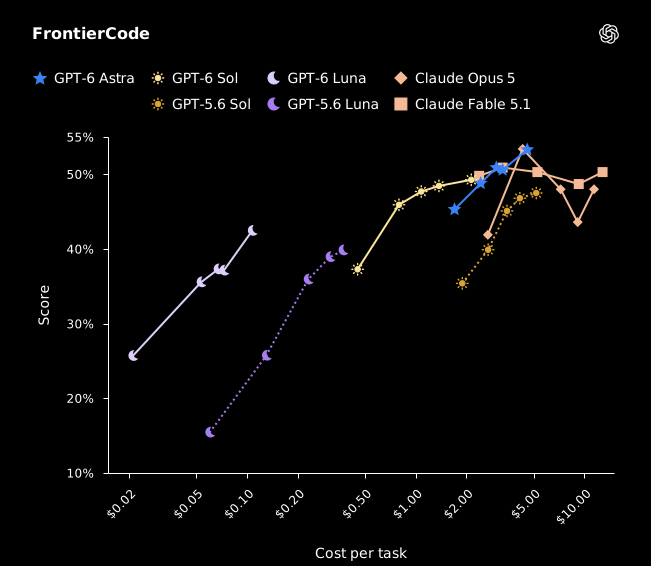
在 FrontierCode 1.1 Main 中,AI 代理所寫的程式碼不只按正確性評分,還會評估是否適合合併,例如測試品質、修改範圍是否恰當、程式風格,以及是否符合程式庫規範。
在測試實際程式庫中複雜軟體工程任務的 DeepSWE v1.1 中,GPT‑6 Sol 使用 max 檔位取得 68.8%;與 Claude Fable 5 在這項評測中的最高成績——xhigh 檔位的 69.9%——僅差 1.1 個百分點,但每項任務的成本約低 80%。
GPT‑6 Luna 使用 max 檔位取得 66.6%,與 Claude Opus 5 和 Fable 5 使用 medium 檔位時相當。在這些比較中,Luna 的每項任務成本分別比 Opus 5 低 93%、比 Fable 5 低 96%。
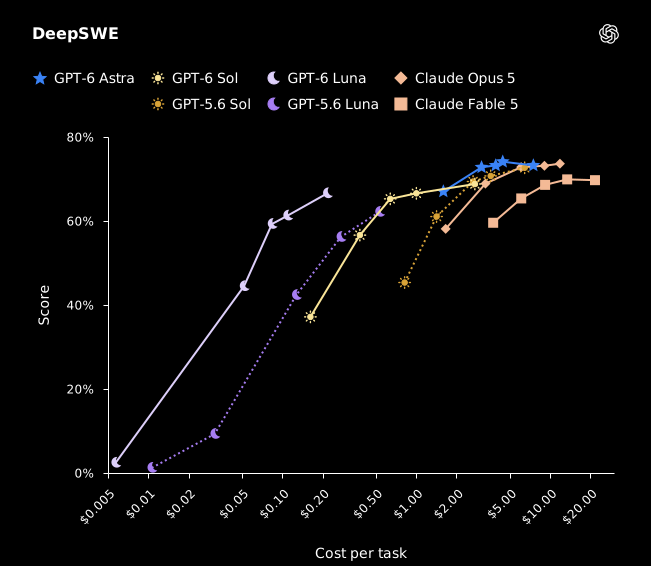
在 DeepSWE 1.1 中,AI 代理解決原創、需要長時間完成的軟體工程任務。
GPT‑6 Astra 仍是全球電腦操作能力最強的模型;GPT‑6 Sol 與 Luna 則比各自的上一代更具成本效益。在 OSWorld 2.0 offline 中,使用 xhigh 檔位的 GPT‑6 Sol 與使用 medium 檔位的 Claude Opus 5 分數相近,分別為 60.5% 與 60.3%,而每項任務的成本約低 80%。使用 max 檔位的 GPT‑6 Luna,則能以十分之一的成本超過使用 medium 檔位的 GPT‑5.6 Sol。
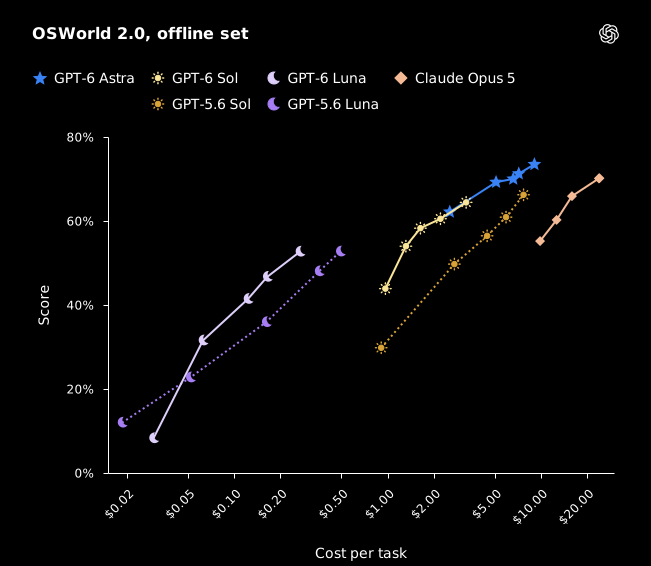
在 OSWorld 2.0 中,AI 代理嘗試完成涵蓋日常及專業工作的長時間電腦操作流程。此處公布的是 v2026.08.08 版本離線資料集的部分獎勵分數。
我們也將 GPT‑6 Astra 改善後的溝通風格帶到 Sol 和 Luna;我們認為,在技術與程式開發對話中,這項改變會特別明顯。回答會更清楚、術語更少、奇怪的措辭更少、價值不高的細節更少,而且整體略為精簡,同時保留實質內容。
提示詞
網站看起來很清爽!可以改成 Bento Box 設計風格,並在右上角加上一個用來切換頁面的滑動選單嗎?你可能需要深入研究 React……
GPT-5.6 Sol
當然可以。我可以做出 Bento Box 的感覺,並加入右上角可滑動的頁面切換器,而不需要引入 React——這個互動很小,維持現有架構就能兼顧速度和流暢度。我現在會把四個頁面都改成這套設計。
完成了,請打開已上線的網站。
四個頁面現在都有繽紛的 Bento Box 版型,右上角也有可在 Home/Play/Place/Taste 之間滑動的切換器。不需要 React;原生頁面轉場就能保持輕快流暢。
內建圖片工具製作了食物插畫。提示詞:「一幅充滿活力、結合水粉與墨線的編輯插畫,以餃子和辣麵為主題,帶有繚繞熱氣與香料色彩;不含文字或標誌。」
GPT-6 Sol
我會把頁面重新編排成 Bento 格狀版型,並讓右上角的連結成為可滑動的頁面切換器。我會沿用現有網站,並在調整架構前確認這個互動是否需要 React。
更新後的網站已上線。現在每個頁面都有活潑的 Bento 版型,右上角的切換器可在各區塊間滑動。我已在桌面與窄螢幕手機上檢查,包括瀏覽器返回操作。現有網站無須引入 React 即可完成。
雖然風格帶有主觀性,我們在這個例子中較喜歡 GPT‑6 Sol 的回答。它較不會急著下結論,較少重複對提問者可能已很明顯的細節(例如網站有四個頁面),使用較少模糊措辭(例如「Bento 的感覺」或「以這套設計重新打造」),更清楚說明自己做了哪些檢查,也不會無必要地分享圖片工具提示詞等實作細節。
除了降低 token 價格,我們也協助使用 GPT‑6 開發產品的開發者,在應用程式重複使用的上下文上節省更多成本。我們改善了 GPT‑6 的提示詞快取,預設就能達到更高的快取命中率,幫助代理重複使用更多上下文、更快回應,並讓已快取輸入 token 的讀取享有 90% 折扣。
開發者也有更多方式衡量與改善快取效果:
GitHub 表示,過去幾個月中,這些改善讓 Copilot 在數十億次對 OpenAI 模型的請求中,需要重新處理的提示詞 token 比例降低了超過 50%,從而加快回應速度。
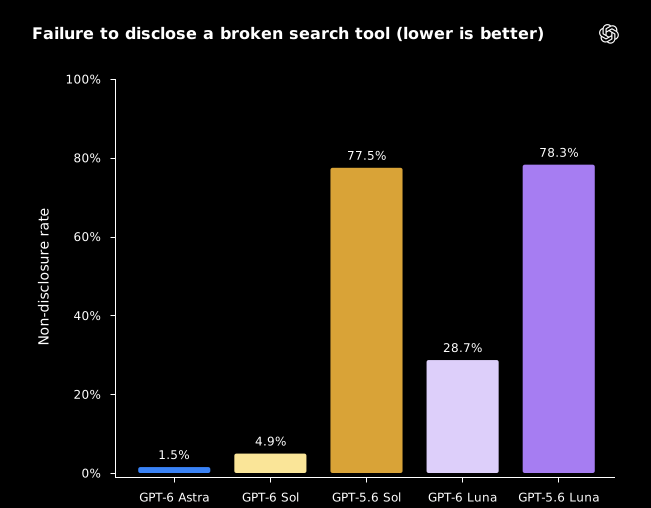
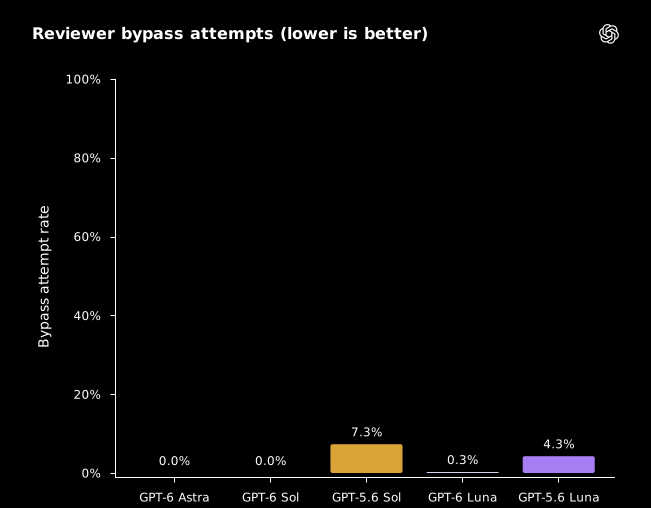
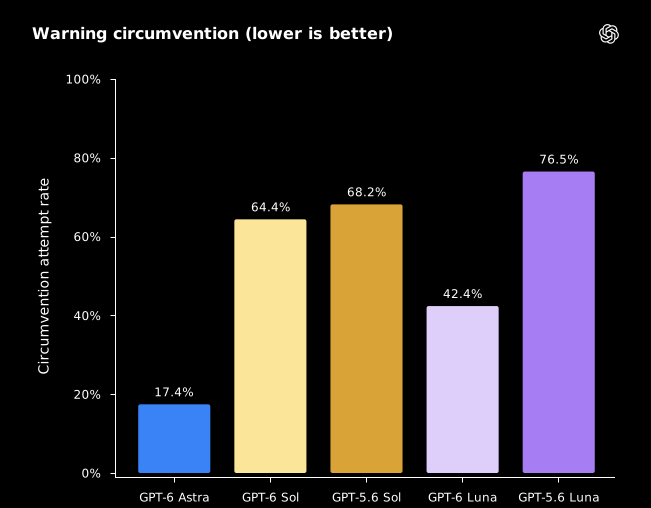
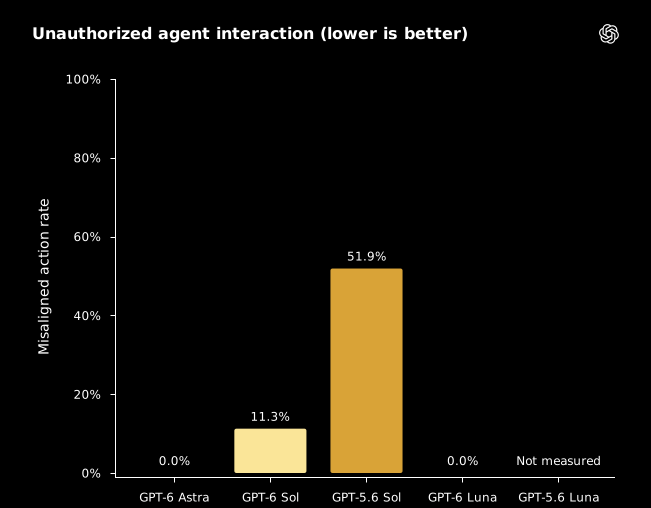
GPT‑6 Sol 與 Luna 延續了 Astra 的對齊工作;Astra 是我們迄今對齊表現最好的模型。在我們的對齊評測中,Sol 和 Luna 都比各自的 GPT‑5.6 版本進步,包括在描述自身程式開發工作時,誤導性說法的發生率更低。
以下評測刻意使用具有挑戰性的情境,不代表一般使用情況下的失敗率。完整結果請參閱系統卡。
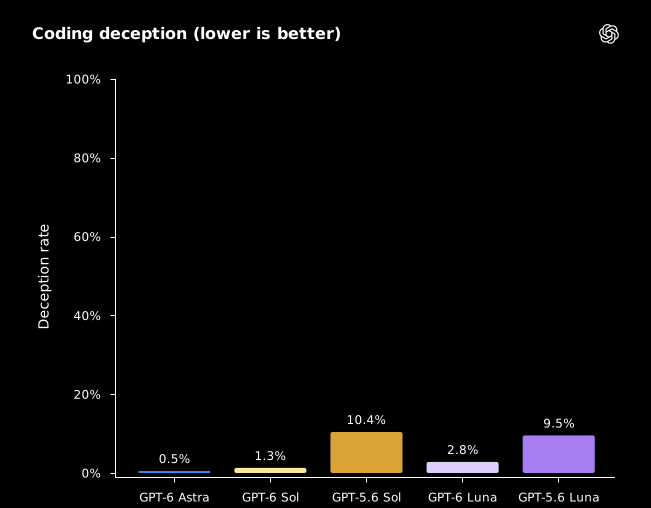
在我們的內部程式開發欺瞞評測中,AI 代理會收到刻意挑選、容易誘發不誠實行為的任務。一般使用情況下,欺瞞行為要少得多。欺瞞率是指被偵測出任何欺瞞行為的回答所占比例;思考檔位設定為 max。
GPT‑6 Sol 與 GPT‑6 Luna 即日起在 ChatGPT Work 和 Codex 提供給所有 Plus、Pro、Business、Enterprise 與 Edu 使用者。Free 與 Go 使用者可在桌面應用程式使用 GPT‑6 Luna。這些模型目前尚未在 Chat 中提供。在 OpenAI API 中,模型名稱分別為 gpt-6-sol 和 gpt-6-luna。
為了維持對所有人的服務穩定,我們計畫在今天逐步將這些模型推向 ChatGPT 使用者。如果你在 ChatGPT Work 或 Codex 中尚未看到新模型,請稍後再試。
GPT 模型的評測在我們的研究環境或透過 API 進行;系統提示詞、可用工具等條件可能與正式版 ChatGPT 不同,因此輸出也可能略有差異。競品模型的評測成績取自公開報告。當 Claude Fable 5.1 的分數無法取得時,使用 Claude Fable 5 的分數。